近日,中国科学院青藏高原研究所、国家青藏高原科学数据中心联合国内多个地学数据中心科研人员,系统提出了“人工智能就绪地球科学数据(AI-ready geoscience data)”的定义框架与实现路径。当前,“人工智能就绪数据(AI-ready data)”已成为学术界和产业界广泛关注的重要概念,但其内涵与判定标准仍缺乏统一认识。数据开放是否意味着人工智能就绪,完成标准化是否即可满足人工智能应用需求,能够用于单一模型训练是否足以称为人工智能就绪,相关认识仍不明确。对于地球科学而言,人工智能就绪并不能简单等同于数据开放、标准化或可被某一人工智能模型直接调用。地球科学数据来源多样、尺度差异显著、模态复杂,并具有较强的时空关联和科学情境依赖,要推动数据由“可获取”进一步转向“可被人工智能可靠理解和利用”,还需系统解决代代表性、语义与时空对齐、多模态组织、质量与不确定性表达以及可信治理等一系列问题。因此,该研究关注的核心不再局限于数据能否被获取和使用,而是数据是否具备支撑人工智能可信学习、跨任务迁移和科学发现的系统能力。
本研究的核心贡献之一是明确了地球科学数据人工智能就绪的定义,包括:代表性(Representativeness)、伦理(Ethics)、对齐(Alignment)、多样性(Diversity)和收益产出(Yield)。在此基础上,研究进一步为READY的五个维度分别设置了从一级到四级的递进属性体系,用于刻画不同维度由基础要求向更高水平人工智能支撑能力的逐级提升。这一体系不仅回答“人工智能就绪数据应具备哪些属性”,还可以进一步判断各项属性当前达到何种水平、存在何种短板以及下一阶段需要提升哪些能力,从而使READY同时具备概念定义、属性分解、成熟度评估和实践指导等功能。由此,“人工智能就绪”从较为宽泛的目标性概念,进一步转化为可描述、可分级、可评估和可实施的数据能力框架。与以往更多关注数据是否可共享、可发现和可复用不同,READY更强调数据能否被人工智能系统有效摄取、正确理解和可靠利用,并进一步支撑模型训练、知识迁移和科学发现。
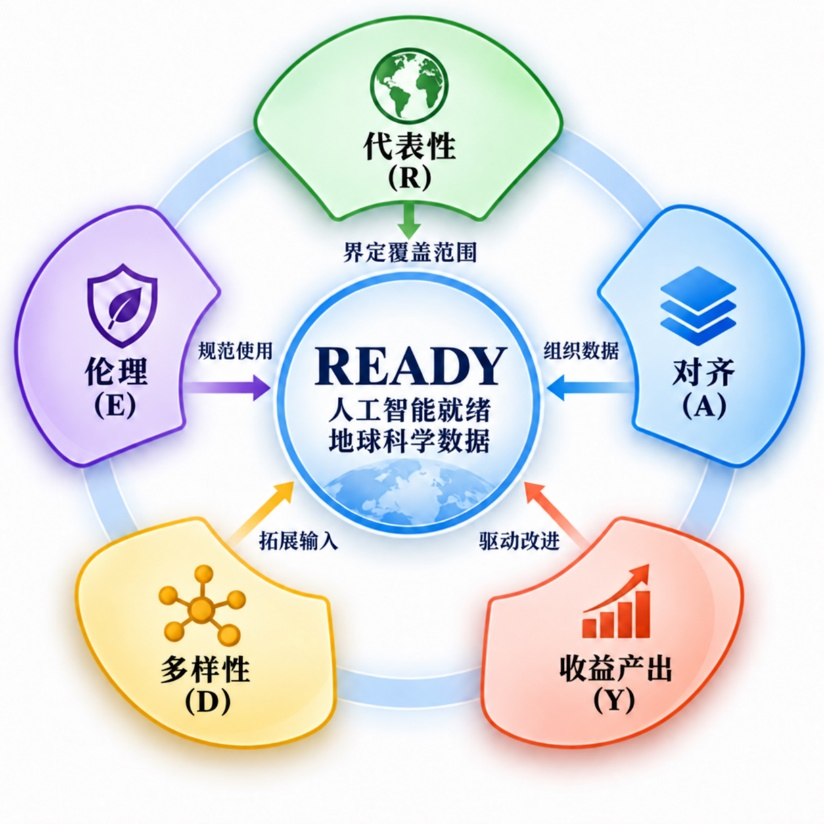
图1 人工智能时代的地球科学数据READY框架
本研究还提出了一条清晰的四阶段演进路线图,将地球科学数据人工智能就绪划分为预就绪(Pre-ready)、机器学习就绪(ML-ready)、基础模型就绪(Foundation-ready)和智能体就绪(Agent-ready)四个阶段。其中,预就绪数据主要依赖人工理解和经验使用;机器学习就绪数据已具备较好的机器摄取、任务适配与效果评估能力,可支撑特定机器学习任务;基础模型就绪数据进一步面向大规模、多模态和跨任务训练,成为支撑基础模型开发的通用数据底座;智能体就绪数据则在此基础上进一步增强可追踪、可调用、可治理和可持续更新能力,以支持智能体在科学流程中的自主发现、调用、转换与验证。该路线图将“AI-ready”从抽象概念转化为可识别、可评估、可推进的数据发展路径。
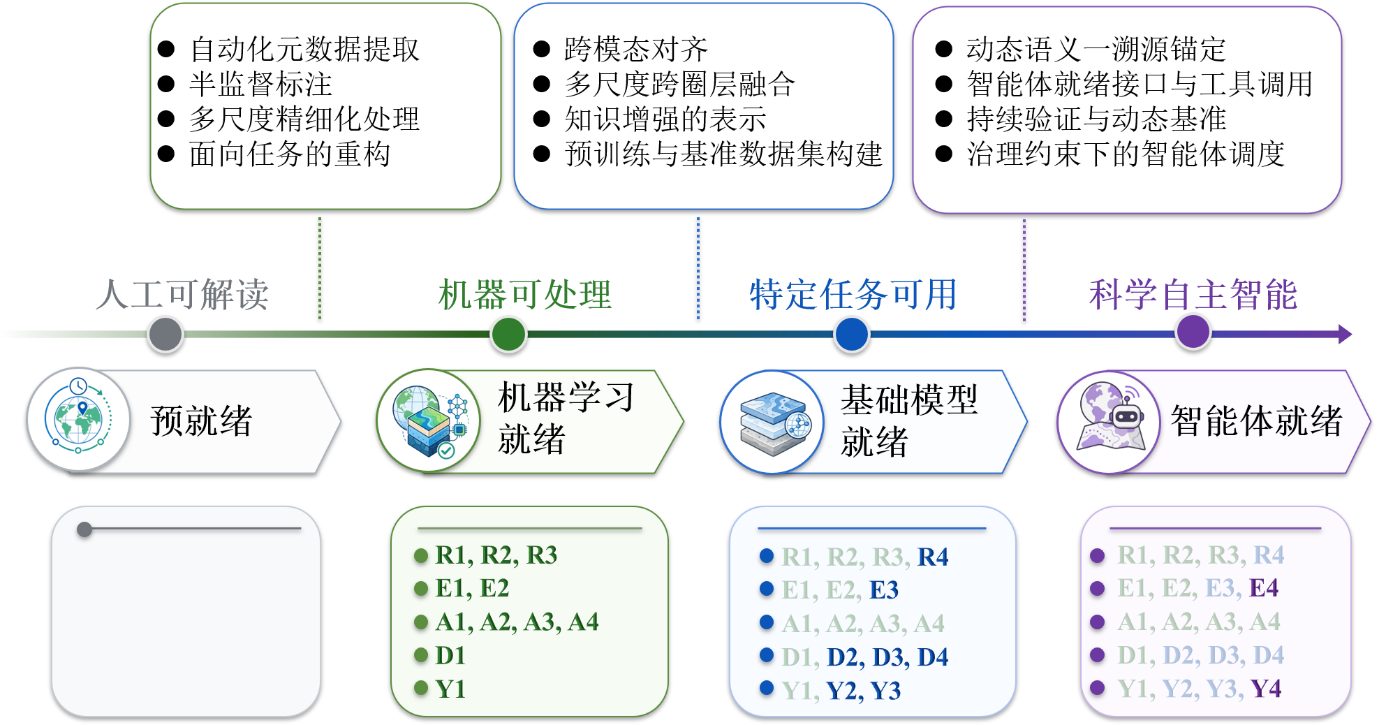
图2 READY属性在四个递进数据阶段中的提升路线图
在此基础上,研究还比较了READY框架与可发现、可获取、可互操作和可重用(FAIR:Findability、Accessibility、Interoperability and Reusability)原则。FAIR原则对推动科学数据开放共享和机器可读环境建设发挥了重要作用,是当前科学数据治理的重要基础。研究指出,FAIR主要回答的是数据能否被发现、访问、互操作和复用的问题,而READY进一步关注的是数据能否真正支撑人工智能训练、跨任务迁移和智能体驱动的科学活动。换言之,一个数据集可以是FAIR的,但仍未必具备足够的代表性、对齐性、多样性或治理能力,因而未必达到AI-ready状态。READY并非替代FAIR,而是在其基础上,将数据治理目标从“面向共享”进一步推进到“面向智能”。
研究团队认为,随着基础模型和科学智能体快速发展,地球科学数据建设正在从“开放共享”迈向“智能可用”的新阶段。对于遥感观测、野外调查、生态监测、模式产品和多媒体科学记录等高度异构的数据资源而言,如何通过系统框架实现高质量组织、跨模态对齐、可计算表达与可信治理,已成为Earth system science(地球系统科学)和Digital Earth(数字地球)发展的关键议题。该研究提出的READY框架及其路线图,为今后地球科学数据标准建设、平台升级、产品研发和智能应用落地提供了系统参考。
本研究回应了“什么样的地球科学数据才算人工智能就绪”这一基础问题,也为地球科学数据从资源形态走向智能形态提供了方法路径。其意义不仅在于提出一个新概念,更在于通过“五维属性—四级递进—四阶段演进”的体系化设计,将READY从概念层面的倡议进一步转化为能够用于评估数据现状、识别能力短板和指导持续提升的实践框架。尽管READY框架主要为满足地球科学数据赋能人工智能应用的现实需求而提出,但其所关注的代表性、伦理、对齐、多样性和收益产出等核心问题具有较强的跨学科共性,因此也可为生命科学、环境科学、材料科学、医学等其他数据密集型科学领域开展人工智能就绪数据建设提供参考。
该研究由中国科学院青藏高原研究所、国家青藏高原科学数据中心、中国科学院空天信息创新研究院、国家对地观测科学数据中心、中国科学院地理科学与资源研究所、国家地球系统科学数据中心、清华大学地球系统科学系以及中国科学院西北生态环境资源研究院、国家冰川冻土沙漠科学数据中心等单位科研人员共同完成。中国科学院青藏高原研究所、国家青藏高原科学数据中心郭彦龙副研究员为论文第一作者,李新研究员为论文通讯作者。该研究得到国家自然科学基金(42430112)的资助。
论文链接:https://doi.org/10.1016/j.infgeo.2026.100061